「AIは、他人の作品を勝手に学習しているのでは?」という疑問を、よく聞きます。
AIの開発・学習の段階で、著作物をどう扱えるかを、やさしくまとめました。
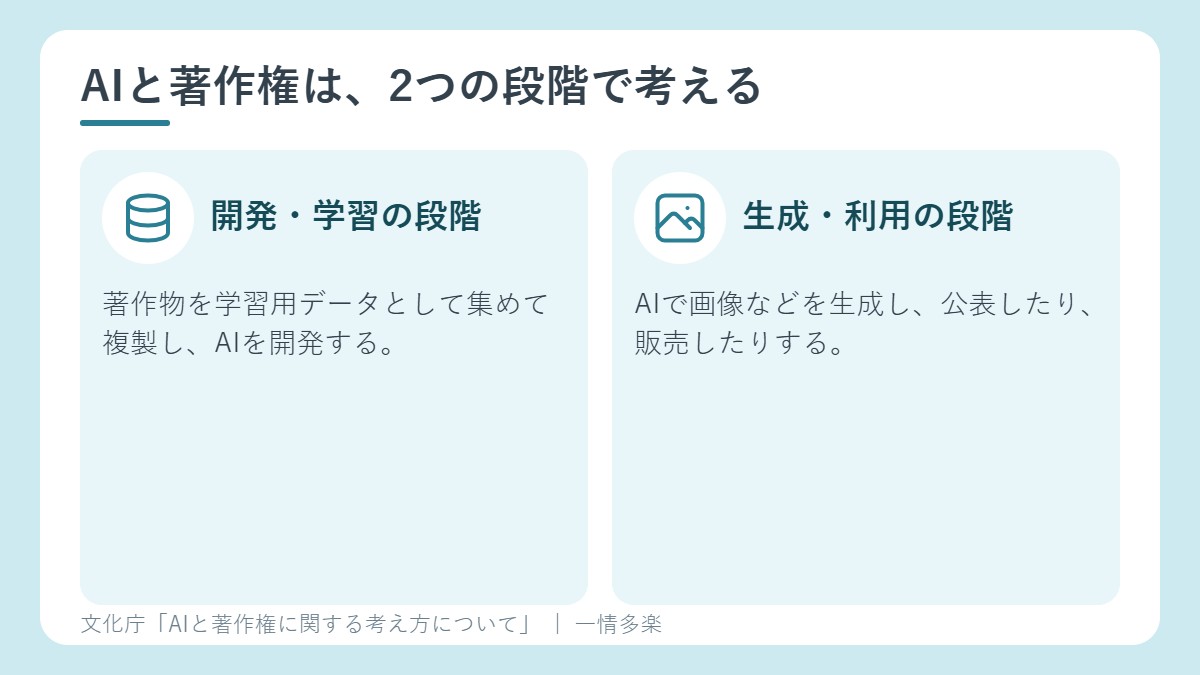
AIと著作権は、2つの段階に分けて考えます
- AI開発・学習の段階: 著作物を学習用データとして集めて複製し、データセットを作ります。それを学習に使って、AI(学習済みモデル)を開発します。
- 生成・利用の段階: AIを使って画像などを生成し、アップロードして公表したり、複製物を販売したりします。
著作権法第30条の4って、なに?
AIの開発のような情報解析で、著作物に表現された思想や感情の「享受」を目的としない利用(非享受目的の利用)は、原則として、著作権者の許諾なく行えます。例は、AIの学習データに使うための、著作物の収集(複製)です。文章なら閲読すること、音楽なら鑑賞することなどが「享受」にあたります。
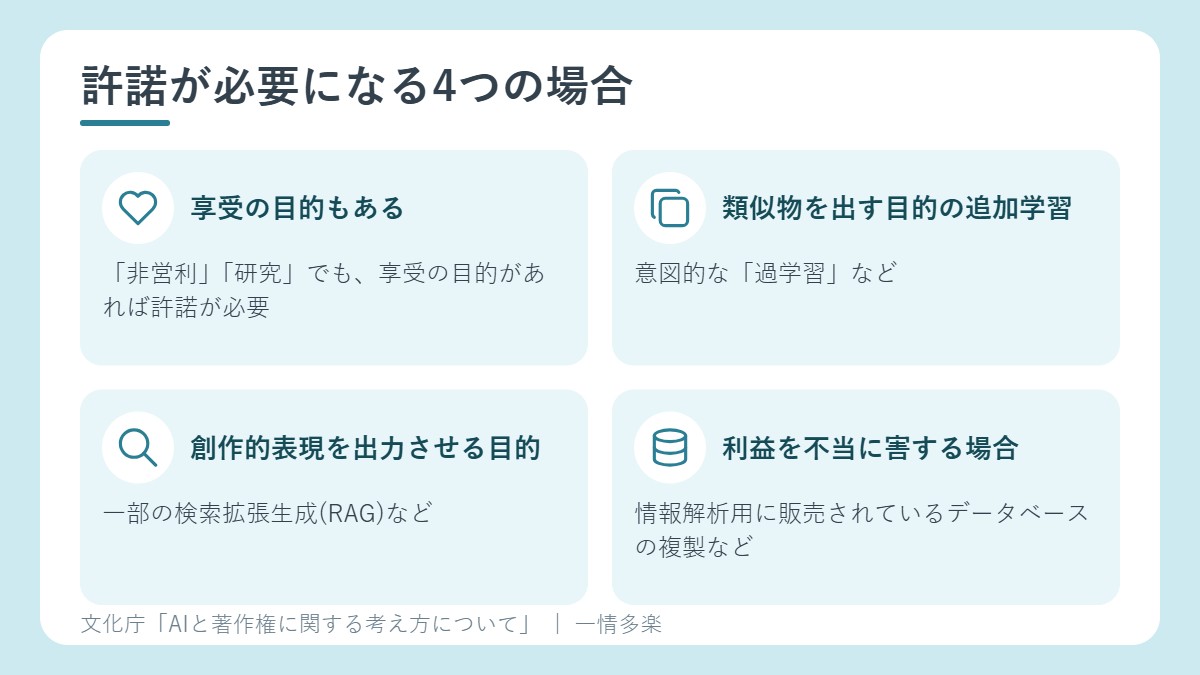
許諾が必要になる場合
- 「非享受目的」と、「享受の目的」が併存している場合。「非営利目的」や「研究目的」でも、享受の目的があれば、許諾が必要です。
- AIの追加学習(ファインチューニング)で、学習データの著作物の類似物を、生成させることを目的としたもの(意図的な「過学習」など)。
- 一部の検索拡張生成(RAG)などで、既存の著作物の創作的表現を、AIに出力させることを目的としたもの。
- 「著作権者の利益を不当に害することとなる場合」。例は、情報解析用に販売されているデータベースの著作物を、AI学習のために複製する場合です。
「作風」は、どうなるの?
著作権法が守るのは、「創作的表現」で、「アイデア」は守られません。そのため、「作風」がアイデアにとどまる場合は、共通していても、著作権侵害にはなりません。ただし、特定のクリエイターの作品だけを集めて、その創作的表現を出力させる目的で追加学習をするような場合は、第30条の4が適用されない場合があります。
海賊版サイトからの収集
AI開発の事業者が、海賊版などの権利侵害の複製物を載せたウェブサイトだと知りながら、学習データを集めることは、「厳に慎むべき」です。そうして開発されたAIが起こす著作権侵害について、事業者が責任を問われる可能性が、高まります。
※文化庁の「考え方」は、現行の著作権法の解釈について、公表時点での審議会としての考え方を示したものです。法的な拘束力はありません。個別の判断は、最終的には裁判所が行います。
関連記事
出典
- 「AIと著作権に関する考え方について」【概要】|文化庁(令和6年4月)(2026年10月12日に確認)